1. Introduction
Dans ce TP pratique, nous allons découvrir Apache Presto à travers un exemple simple utilisant deux systèmes de gestion de bases de données : PostgreSQL et MySQL.
L’objectif est de comprendre comment Presto peut servir de moteur de requêtes SQL distribué capable d’interroger plusieurs sources de données depuis une seule interface.
Nous allons progressivement :
- installer Apache Presto ;
- préparer une base de données PostgreSQL ;
- préparer une base de données MySQL ;
- configurer les connexions PostgreSQL et MySQL dans Presto ;
- vérifier que Presto communique correctement avec les deux bases ;
- exécuter des requêtes SQL ;
- réaliser une jointure entre PostgreSQL et MySQL avec Presto.
À la fin du TP, vous aurez compris le principe de la fédération de données avec Apache Presto.
2. Prérequis
Ce TP est destiné aux débutants.
Vous devez disposer de :
- quelques connaissances de base en SQL ;
- PostgreSQL installé sur votre ordinateur ;
- MySQL installé sur votre ordinateur ;
- Java installé ;
- Apache Presto installé ;
- un terminal ou une invite de commandes.
Nous utiliserons des données très simples afin de nous concentrer sur le fonctionnement de Presto.
3. Définition de la fédération de données avec Apache Presto
La fédération de données c’est interroger plusieurs bases de données différentes depuis un seul endroit, avec une seule requête SQL, sans déplacer les données.
4. A quel moment penser a faire de la federation
- Données dispersées + besoin de les analyser ensemble + pas envie de les déplacer = penser à la fédération de données.
- Tes données sont déjà dans plusieurs bases et tu dois les croiser.
- Tu dois faire un rapport ponctuel à partir de plusieurs systèmes.
- Tu ne veux pas créer un ETL juste pour récupérer quelques données.
- Tu veux analyser rapidement des données provenant de PostgreSQL, MySQL, MongoDB, fichiers, etc.
- Les systèmes doivent rester indépendants : tu ne veux pas déplacer leurs données.
5. Études de cas de la fédération de données avec Apache Presto
5.1. Cas 1 – Banque
Une banque possède plusieurs systèmes : le core banking contient les comptes et les clients, le système de cartes bancaires contient les transactions par carte, et le système de crédit contient les prêts.
Pour analyser le profil financier d’un client sans déplacer toutes les données dans une seule base, on peut interroger les différentes sources avec une couche de fédération.
Entités :
- Client
- Compte
- Carte
- Transaction
- Crédit
Exemple : retrouver les clients ayant un compte, une carte bancaire et un crédit en cours, puis calculer leur exposition financière globale.
5.2. Cas 2 – Opérateur télécom
Un opérateur télécom peut avoir une base pour les abonnés, une autre pour les appels, une autre pour la consommation Internet et une autre pour la facturation.
Le service marketing souhaite analyser la consommation des clients sans attendre une migration de toutes les données vers une même base.
Entités :
- Abonné
- Appel
- Session Internet
- Forfait
- Facture
- Paiement
Exemple : identifier les abonnés qui consomment beaucoup de données Internet mais génèrent peu de revenus.
5.3. Cas 3 – E-commerce
Une plateforme e-commerce peut stocker les clients dans PostgreSQL, les commandes dans MySQL et les événements de navigation dans une plateforme Big Data.
La direction veut croiser ces informations pour comprendre le comportement des clients.
Entités :
- Client
- Produit
- Commande
- Paiement
- Visite
- Panier
Exemple : trouver les clients qui consultent régulièrement un produit mais ne l’achètent pas.
5.4. Cas 4 – Hôpital
Un établissement de santé peut avoir plusieurs applications : le dossier patient, la facturation, la pharmacie et le laboratoire. Les données sont donc réparties dans différents systèmes.
Une équipe d’analyse souhaite produire un rapport global sans remplacer les applications existantes.
Entités :
- Patient
- Consultation
- Examen
- Résultat
- Médicament
- Facture
Exemple : analyser les examens réalisés et les coûts associés aux patients sur une période donnée.
5.5. Cas 5 – Grande entreprise
Une entreprise internationale possède un système RH, un ERP pour les ventes et un système financier. Chaque application utilise sa propre base de données.
La direction souhaite obtenir rapidement un tableau de bord combinant les informations.
Entités :
- Employé
- Département
- Client
- Commande
- Produit
- Facture
- Paiement
Exemple : comparer les performances commerciales d’une équipe avec son chiffre d’affaires et les données financières.
5.6. Cas 6 – Transport / compagnie aérienne
Une compagnie aérienne peut avoir un système pour les passagers, un autre pour les réservations, un autre pour les vols et un autre pour les paiements.
Pour analyser les revenus par vol, destination ou passager, il faut croiser ces différentes sources.
Entités :
- Passager
- Réservation
- Vol
- Avion
- Destination
- Paiement
Exemple : calculer le chiffre d’affaires généré par chaque destination en croisant les réservations et les paiements.
5.7. Cas 7 – Groupe d’entreprises avec plusieurs filiales
Un groupe possède plusieurs filiales, et chaque filiale utilise son propre système informatique et sa propre base de données. Les données commerciales restent donc réparties entre les différents systèmes.
La direction du groupe souhaite produire un rapport consolidé sans demander à chaque filiale de migrer ses données vers une base centrale.
Entités :
- Groupe
- Filiale
- Client
- Produit
- Commande
- Facture
- Paiement
Exemple : la direction veut connaître le chiffre d’affaires global du groupe, puis le comparer entre les filiales.
6. Comprendre l’architecture du TP
Avant de commencer, il est important de comprendre le rôle de chaque composant.
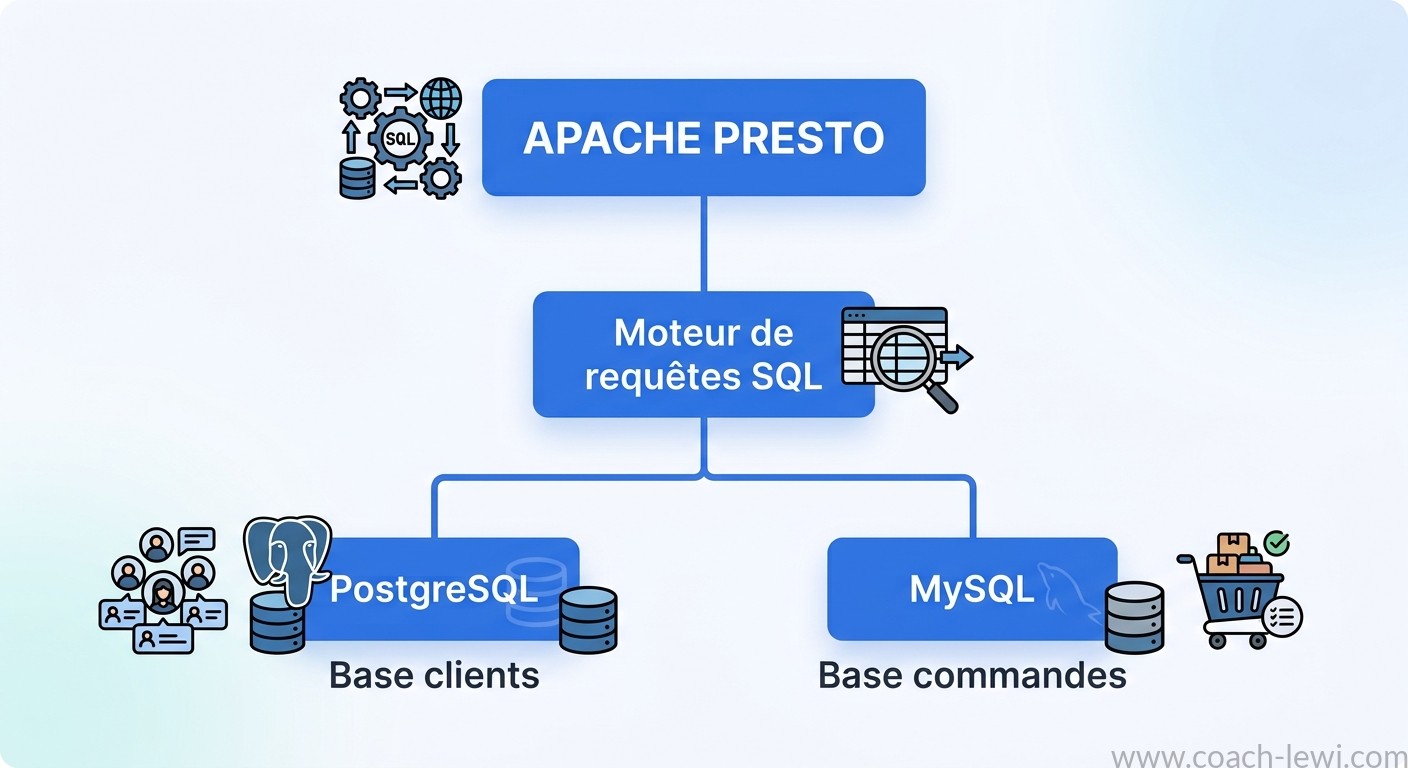
PostgreSQL et MySQL restent deux bases de données indépendantes.
Presto intervient comme une couche permettant d’interroger ces différentes sources.
Par exemple, nous pourrons demander à Presto :
SELECT *
FROM postgresql.entreprise_pg.clients;
ou :
SELECT *
FROM mysql.entreprise_mysql.commandes;
Mais l’intérêt devient encore plus important lorsque nous pouvons effectuer une requête utilisant les deux sources :
SELECT
    c.nom,
    c.ville,
    o.montant
FROM postgresql.entreprise_pg.clients c
JOIN mysql.entreprise_mysql.commandes o
    ON c.id = o.client_id;
Cette requête permet à Presto de récupérer les données provenant de PostgreSQL et MySQL et de les exploiter dans une même requête SQL.
7. Installer Java
Apache Presto nécessite Java pour fonctionner.
Vérifiez d’abord si Java est déjà installé :
java -version

Si Java est correctement installé, vous devriez obtenir une réponse indiquant la version de Java utilisée.
Si la commande n’est pas reconnue, installez une version de Java compatible avec la version de Presto utilisée dans votre environnement.
Après l’installation, relancez :
java -version
et vérifiez que Java est bien disponible dans le terminal.
8. Télécharger Apache Presto
Téléchargez Apache Presto depuis sa source officielle.
https://prestodb.io/getting-started/
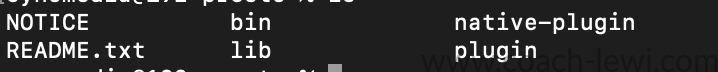
Une fois l’archive téléchargée (presto-server-0.298.1.tar.gz), décompressez-la dans un dossier dédié.
Par exemple :
9. Créer le dossier de configuration
Dans le dossier d’installation de Presto, créez :
etc/
mkdir -p etc/catalog
ls
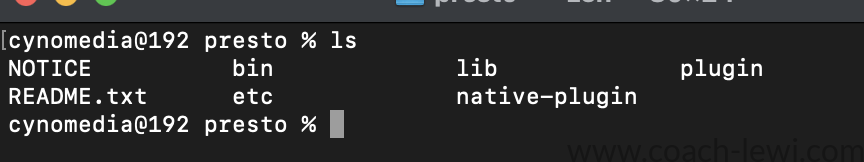
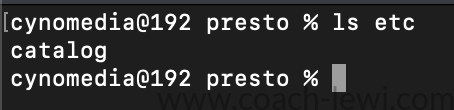
Ensuite vérifie le dossier etc :
ls etc/
Tu devrais voir :
Nous aurons finalement une structure similaire à :
presto/
└── etc/
    └── catalog/
Le dossier catalog est particulièrement important.
C’est ici que nous allons déclarer les différentes sources de données accessibles depuis Presto.
Il sera normalement vide pour le moment.